Un tableau de bord entièrement vert ne garantit pas qu’une entreprise pourra redémarrer après une panne. Une copie peut être incomplète, une clé de chiffrement inaccessible ou une application incapable de reconnaître les fichiers récupérés. La preuve utile reste une remise en service réellement exécutée, chronométrée et validée par les utilisateurs. Cette vérification concerne aussi bien les serveurs installés dans les locaux que les environnements cloud et les logiciels accessibles par abonnement.
Prenons le cas fictif d’Atelier Rivage, une PME qui fabrique du mobilier et gère ses commandes dans un ERP. Ses copies nocturnes semblent fonctionner, mais personne n’a encore essayé de reconstruire le service sur une machine vierge. Pour savoir ce qui se passerait après une défaillance, sa responsable informatique, Nadia, organise un exercice progressif : définir les exigences métier, examiner les copies disponibles, restaurer dans un espace isolé, contrôler le résultat et conserver les preuves. Cette démarche transforme une confiance supposée en capacité mesurable, sans imposer immédiatement une infrastructure de secours complexe.
Définir les critères d’un test de restauration après une panne

La première question n’est pas « quel bouton faut-il utiliser ? », mais « quelle activité doit redevenir possible ? ». Chez Atelier Rivage, récupérer les documents commerciaux ne suffit pas : l’équipe doit consulter les commandes, connaître les stocks et éditer les bons de fabrication. Le périmètre de l’exercice part donc du travail attendu, puis remonte vers les composants techniques nécessaires.
Une sauvegarde informatique conserve des éléments ; une reprise remet un service utilisable à disposition. Entre les deux interviennent l’installation du logiciel, les accès, les connexions réseau et les contrôles métier. Cette distinction évite de déclarer une réussite simplement parce qu’un dossier a retrouvé sa place sur un disque.
Fixer un RPO et un RTO adaptés aux applications critiques

Le RPO représente la perte maximale de données acceptable, exprimée en durée. Si l’entreprise tolère au plus deux heures de saisie perdues, elle doit disposer d’un point récupérable suffisamment récent ; une copie unique réalisée chaque nuit ne répond pas systématiquement à cette exigence.
Le RTO désigne le délai cible de remise en service après l’interruption. Il doit intégrer les étapes nécessaires jusqu’au retour d’un fonctionnement validé, et pas seulement le transfert des fichiers. Pour éviter les comparaisons trompeuses, Nadia précise également le point de départ du chronométrage et mesure séparément les délais de détection et de mobilisation.
Ces objectifs se discutent avec les responsables opérationnels. Le commercial sait quelles commandes pourraient être ressaisies ; la production connaît les conséquences d’un arrêt des machines. Examiner le coût d’une interruption de service aide à arbitrer entre les moyens techniques nécessaires et les pertes supportables.
| Service concerné | RPO illustratif | RTO illustratif | Validation attendue |
|---|---|---|---|
| Gestion des commandes | 2 heures | 4 heures | Retrouver les commandes et créer un bon de fabrication |
| Documents partagés | 24 heures | 1 journée | Ouvrir les fichiers et vérifier les droits |
| Archives historiques | 24 heures | 3 jours | Consulter un dossier complet et ses pièces associées |
Ces valeurs illustrent des choix possibles, pas des recommandations universelles. Une boutique en ligne, un cabinet médical et un atelier industriel n’ont ni les mêmes contraintes ni les mêmes conséquences en cas de perte. Les engagements contractuels et les obligations applicables doivent aussi entrer dans la décision.
Cartographier les dépendances avant de lancer la récupération
Nadia découvre que l’ERP dépend d’un annuaire, d’un serveur de licences et d’un partage contenant les plans techniques. Elle ajoute les certificats, les paramètres de connexion et les installateurs au périmètre. Sans cette cartographie, une base parfaitement récupérée pourrait rester inutilisable pendant plusieurs heures.
Les accès d’urgence méritent une attention particulière. Un mot de passe conservé uniquement dans une messagerie indisponible crée une impasse ; une authentification multifacteur liée au téléphone d’un salarié absent peut également bloquer l’intervention. Les moyens de dépannage doivent être sécurisés, documentés et utilisables par des personnes autorisées.
Enfin, chaque composant reçoit un responsable et un ordre de remise en route. Cette préparation révèle parfois des dépendances circulaires, comme un coffre de secrets accessible seulement grâce au service qu’il faut reconstruire. Le bon périmètre est celui qui permet d’exécuter une opération métier complète, pas seulement de rallumer un serveur.
Vérifier que les sauvegardes sont lisibles, complètes et accessibles
Avant une reconstruction d’ensemble, Nadia examine les copies existantes. Elle contrôle la date, le périmètre couvert, les exclusions et les avertissements du logiciel. Une tâche annoncée comme terminée peut avoir ignoré des fichiers ouverts, un volume récemment ajouté ou un répertoire exclu par une ancienne règle.
La vérification des sauvegardes doit rapprocher la configuration prévue et les données réellement protégées. Chez Atelier Rivage, les plans de fabrication ont récemment changé de serveur : le déplacement apparaît dans l’inventaire, mais pas dans la politique de copie. Ce simple rapprochement évite une découverte beaucoup plus coûteuse pendant un incident.
Contrôler toute la chaîne nécessaire au point demandé
Une copie complète ne suffit pas toujours pour retrouver l’état souhaité. Selon la technologie employée, il faut aussi disposer des incréments, des différentiels ou des journaux de transactions correspondants. Un maillon manquant peut empêcher d’atteindre une date pourtant visible dans le catalogue.
Nadia sélectionne plusieurs générations, dont une plus ancienne. Tester uniquement la dernière version laisserait dans l’ombre les défauts de rétention ou les supports devenus illisibles. Pour une suppression découverte tardivement, la capacité à revenir plusieurs semaines en arrière peut compter davantage que la fraîcheur de la dernière exécution.
- Disponibilité : retrouver le support, le dépôt distant et le catalogue sans dépendre du serveur défaillant.
- Déchiffrement : accéder aux clés nécessaires avec des autorisations contrôlées.
- Exhaustivité : confirmer la présence des volumes, bases, configurations et pièces associées.
- Exploitabilité : récupérer un échantillon représentatif et l’ouvrir avec le logiciel approprié.
- Traçabilité : conserver les dates, identifiants des points sélectionnés et messages d’erreur.
Cette inspection doit inclure les fichiers volumineux et les petits objets nombreux. Restaurer une archive unique de plusieurs gigaoctets ne sollicite pas le stockage comme récupérer des centaines de milliers de documents. Les performances observées sur un échantillon trop simple peuvent donner une image trompeuse du délai réel.
Utiliser les outils natifs sans surestimer leur portée
Les contrôles fournis par le logiciel de protection constituent un premier niveau utile. Ils peuvent détecter des blocs illisibles ou des incohérences du dépôt, selon leurs fonctions. Leur succès ne prouve toutefois ni le démarrage d’une application ni la possibilité de traiter une commande.
PowerShell permet notamment de calculer des empreintes avec Get-FileHash et de comparer un fichier récupéré à une référence fiable. Une correspondance démontre l’identité des contenus comparés, mais pas leur pertinence métier : un document déjà corrompu au moment de sa copie peut conserver une empreinte parfaitement cohérente.
CHKDSK et fsck examinent, dans leurs environnements respectifs, la cohérence de systèmes de fichiers ; ils ne certifient pas à eux seuls la récupérabilité d’un dépôt. Certaines options modifient les volumes contrôlés et exigent des précautions. Robocopy peut aider à comparer ou transférer des arborescences, sans remplacer une validation applicative.
Pour une base, Nadia utilise les mécanismes d’intégrité propres au moteur et prépare une ouverture effective sur une instance de test. Les relations entre tables et les transactions doivent rester cohérentes, ce qu’une simple comparaison de tailles ne démontre pas. Un contrôle technique réduit l’incertitude ; seule l’utilisation des éléments récupérés confirme leur valeur opérationnelle.
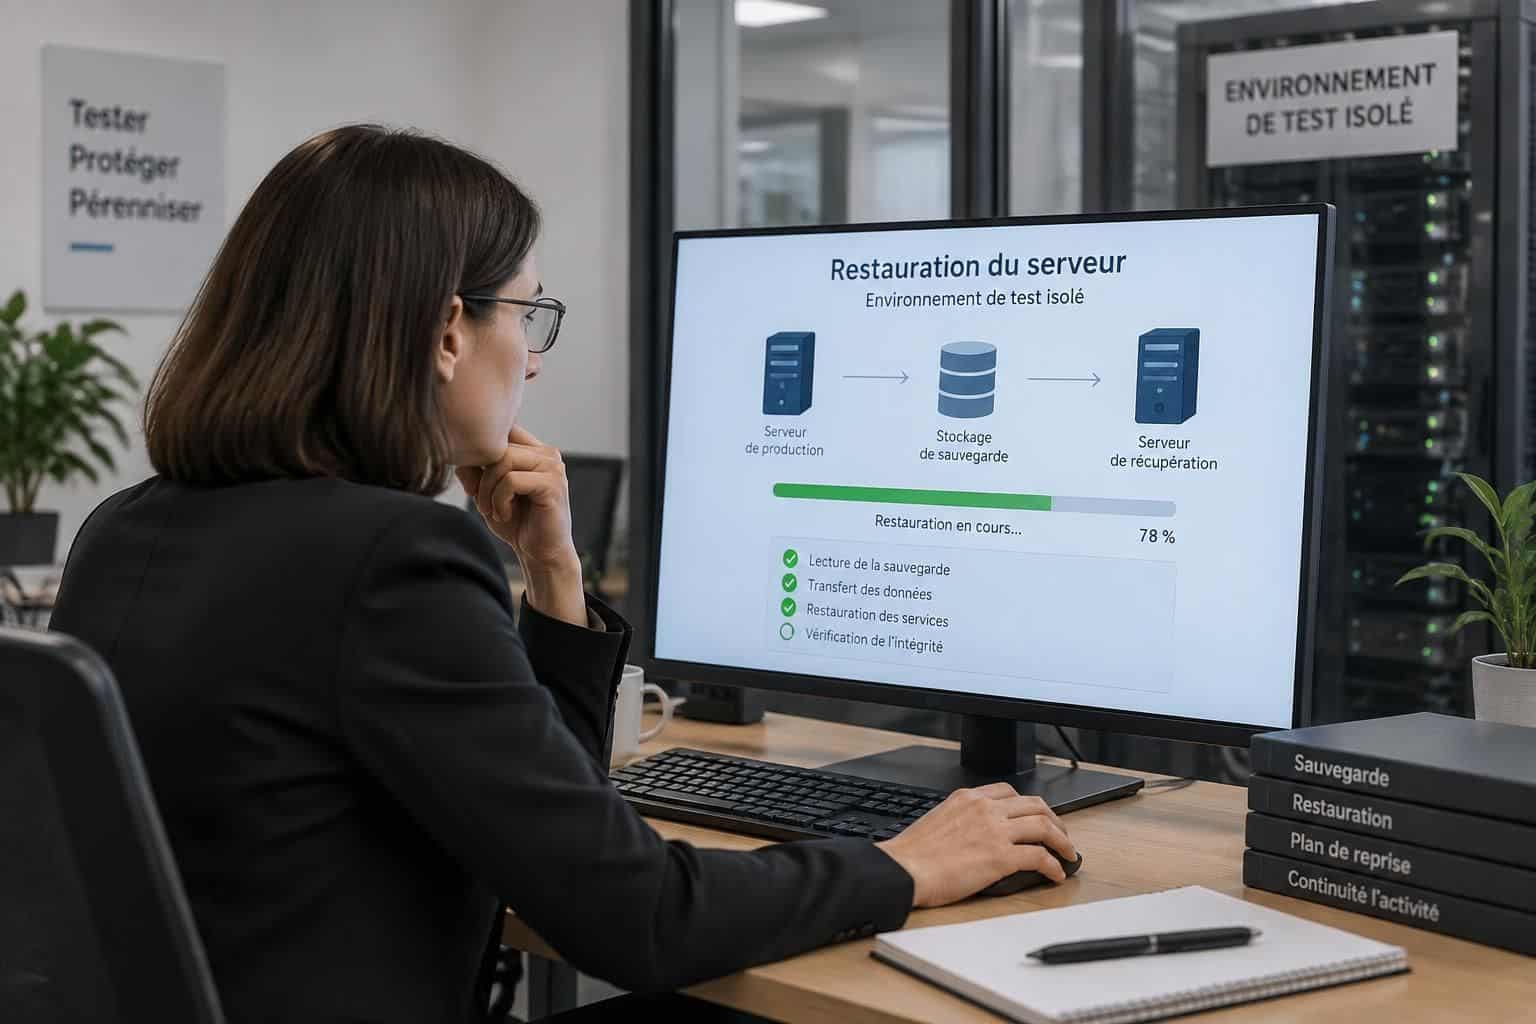
Effectuer une restauration complète dans un environnement isolé
Après les contrôles préalables, Nadia prépare une infrastructure distincte de la production. Son objectif est de reproduire les conditions utiles sans provoquer un nouvel incident. Une simulation de panne n’exige pas de couper brutalement un serveur actif : elle peut partir de l’hypothèse documentée que celui-ci est définitivement indisponible.
L’espace de test reprend les versions logicielles, les ressources et les contraintes réseau pertinentes. Il n’a pas besoin d’être identique sur chaque détail, mais ses différences doivent être connues. Un matériel beaucoup plus rapide que celui réellement prévu pour le dépannage fausserait, par exemple, la mesure du temps nécessaire.
Empêcher les interactions involontaires avec la production
Une application reconstruite peut lancer automatiquement des tâches, envoyer des courriels ou contacter des services externes. Nadia bloque donc les communications non indispensables et redirige les sorties autorisées vers des services de test. Les paiements, notifications commerciales et synchronisations doivent rester neutralisés pendant l’exercice.
Les données utilisées conservent leur sensibilité, même hors production. L’environnement reste soumis à des restrictions d’accès, à une journalisation et à une politique d’effacement. Si une anonymisation est nécessaire, elle doit préserver les relations utiles aux essais sans être confondue avec une preuve de restitution strictement identique.
Le déroulement suit une procédure de récupération écrite, accessible indépendamment du système touché. Un collègue accompagne Nadia et note les étapes qui nécessitent une explication orale. Ces hésitations révèlent les connaissances encore concentrées dans la tête d’une seule personne.
- Déclarer le scénario retenu et lancer les mesures de temps convenues.
- Préparer le réseau isolé, les ressources et les accès administratifs autorisés.
- Reconstruire les services fondamentaux nécessaires à l’application.
- Récupérer les volumes et la base depuis le point sélectionné.
- Remettre les paramètres, licences et connexions indispensables.
- Démarrer le service, puis lancer les vérifications techniques et métier.
Pour une machine virtuelle, le démarrage de l’image ne suffit pas. Il faut examiner les services internes, les disques attendus et les éventuels changements d’adressage. Une reconstruction sur matériel neuf peut également exiger des pilotes, des adaptations du démarrage ou une nouvelle activation logicielle.
Intégrer les contraintes du cloud et des applications SaaS
Dans le cloud, la capacité disponible compte autant que les fichiers conservés. Quotas, autorisations intercomptes, clés de chiffrement et disponibilité des API peuvent limiter le redéploiement. Les données placées en stockage d’archive imposent parfois un délai de réhydratation avant même le début du transfert.
Une réplication entre zones n’équivaut pas automatiquement à une copie indépendante permettant de revenir avant une suppression. Si l’effacement est répliqué, plusieurs emplacements peuvent reproduire la même perte. La stratégie doit donc distinguer disponibilité immédiate, conservation historique et protection contre les actions destructrices.
Pour le CRM en ligne d’Atelier Rivage, Nadia vérifie les fonctions contractuelles de récupération. Un export de contacts ne contient pas nécessairement les pièces jointes, les automatisations et les droits. Il faut essayer la réimportation et vérifier ce qui doit être reconstitué séparément.
La restauration complète révèle ainsi les contraintes que les rapports quotidiens ne montrent pas : installateur introuvable, débit insuffisant, licence oubliée ou ordre de démarrage incorrect. Chaque écart est consigné au moment où il apparaît, car une solution improvisée mais non documentée resterait fragile lors du prochain incident.
Valider l’intégrité des données et mesurer la reprise réelle
Le serveur répond et l’ERP affiche son écran d’accueil. Pour Nadia, le contrôle décisif commence seulement : les utilisateurs doivent retrouver des informations exactes et accomplir leur travail. Un démarrage réussi peut masquer des pièces manquantes, des droits excessifs ou une transaction restée incomplète.
La validation comporte donc trois niveaux : contenu, fonctionnement et performances. Chacun produit des preuves distinctes. Un fichier lisible ne garantit pas que son propriétaire dispose du bon accès, et une requête rapide sur une petite table ne démontre pas que l’ensemble du service supportera la charge habituelle.
Contrôler les contenus, les droits et les transactions
Pour les documents, Nadia compare un échantillon de références, ouvre plusieurs formats et contrôle les métadonnées importantes. Elle vérifie également les propriétaires et les autorisations. Un dossier financier devenu accessible à tous constituerait un échec de sécurité, même si chaque fichier était intact.
L’intégrité des données exige des contrôles adaptés au moteur de base et aux règles de gestion. Les vérifications portent notamment sur les relations entre enregistrements, les totaux attendus et les opérations proches de l’heure de coupure. Les contrôles techniques et les rapprochements métier se complètent.
Chez Atelier Rivage, le responsable commercial sélectionne trois commandes connues : une ancienne, une modifiée récemment et une accompagnée d’un plan. Il vérifie les quantités, les coordonnées, les pièces jointes et l’état de traitement. Cette sélection raisonnée est plus probante qu’une consultation aléatoire de l’écran principal.
Un utilisateur de production crée ensuite un bon de fabrication dans l’espace isolé. L’opération doit mobiliser les bons stocks, conserver les liens documentaires et produire le résultat attendu. Les sorties restent neutralisées afin que cet essai ne déclenche aucune action réelle dans l’atelier.
Comparer les délais observés aux objectifs annoncés
Nadia relève les heures de début, de disponibilité des données, de démarrage et d’acceptation métier. Elle découvre que le transfert prend cinquante minutes, mais que la préparation et les vérifications ajoutent deux heures. Le temps de copie n’est donc qu’une fraction du délai de remise en service.
Pour évaluer le respect du RPO, elle identifie la dernière transaction effectivement récupérée et la compare à l’heure de l’incident simulé. Une copie terminée à une heure donnée peut correspondre à un état antérieur. L’heure d’achèvement du traitement ne suffit donc pas à établir la fraîcheur des informations récupérables.
Les essais incluent aussi plusieurs utilisateurs simultanés et des opérations représentatives. Une infrastructure provisoire peut convenir à la consultation sans supporter la création intensive de commandes. Dans ce cas, un fonctionnement dégradé doit être explicitement défini et accepté, plutôt que présenté comme un retour normal.
Si la cible n’est pas atteinte, l’analyse distingue les causes. Des copies plus fréquentes répondent à un problème de fraîcheur ; un accès réseau plus rapide peut réduire les transferts ; un meilleur guide limite les hésitations. Aucun de ces leviers ne remplace automatiquement les autres.
Le chiffrage des pertes liées à l’arrêt permet ensuite de hiérarchiser les améliorations. Atelier Rivage peut financer un stockage plus rapide pour son ERP tout en conservant une solution moins coûteuse pour ses archives. La réussite se mesure au service rendu dans les limites convenues, pas au seul message de fin de traitement.
Tester la résistance des sauvegardes et documenter les corrections
Une panne matérielle laisse souvent le dépôt de protection intact ; une attaque peut viser simultanément les serveurs et leurs copies. Nadia ajoute donc un scénario dans lequel l’annuaire principal et les comptes habituels ne sont plus fiables. L’équipe doit démontrer qu’elle conserve une voie d’accès indépendante et contrôlée.
La stratégie dite 3-2-1 fournit un cadre : trois exemplaires des données, sur deux types de supports, dont un hors site. Elle ne garantit toutefois pas, à elle seule, la résistance aux suppressions malveillantes. L’isolement, les droits d’administration et les durées de conservation doivent être examinés concrètement.
Récupérer une copie de secours sans dépendre d’un environnement compromis
Une copie de secours située dans un autre bâtiment peut rester vulnérable si les mêmes comptes permettent de l’effacer. À l’inverse, une conservation immuable correctement configurée ou un support hors ligne réduit certains risques. Ces protections répondent à des mécanismes différents et doivent être testées selon les possibilités du dispositif.
Nadia vérifie qui peut changer les règles de rétention, supprimer les versions et accéder aux clés. Elle examine aussi les procédures d’urgence et les contacts du prestataire. Le chiffrement protège la confidentialité, mais il ne rend pas un dépôt indestructible et ne remplace pas la séparation des privilèges.
Après une compromission, retrouver une version ancienne ne signifie pas qu’elle est saine. Le choix du point de retour repose sur l’analyse de l’incident, les traces disponibles et les contrôles de sécurité. Une analyse antivirus seule ne permet pas d’affirmer l’absence de toute présence malveillante.
L’exercice prévoit donc une reconstruction dans un environnement maîtrisé, la correction des vulnérabilités exploitées et le renouvellement des secrets concernés. Les éléments utiles à l’investigation sont préservés avant les opérations susceptibles de les altérer. La rapidité ne doit pas conduire à réintroduire la cause de l’incident.
Conserver des preuves utiles au plan de reprise
Le plan de reprise évolue à partir des résultats observés. Pour une PME, un compte rendu court peut suffire au premier exercice, à condition qu’il soit précis. Il doit permettre à une autre personne de comprendre ce qui a été réellement démontré et ce qui reste hors périmètre.
- Scénario, date, participants et composants concernés.
- Versions récupérées, références des copies et procédures suivies.
- Délais mesurés, fraîcheur obtenue et résultats des contrôles.
- Anomalies, conséquences opérationnelles et solutions temporaires.
- Actions correctives, responsables, échéances et date du nouvel essai.
Les journaux et captures apportent des preuves, mais peuvent contenir des informations sensibles. Leur conservation doit donc être organisée avec des droits et une durée adaptés. Le dossier d’intervention lui-même doit rester accessible lorsque les outils habituels de collaboration sont indisponibles.
La fréquence dépend de la criticité, des changements et des obligations applicables. Des contrôles ciblés mensuels sur les services essentiels, des exercices trimestriels sur d’autres applications et une revue plus large annuelle constituent un exemple de calendrier à adapter, non une règle universelle.
Une migration, une modification majeure des accès ou un changement de logiciel justifie un nouvel essai sans attendre l’échéance suivante. Les tâches répétitives peuvent être automatisées : démarrage d’une machine isolée, contrôles de services, vérification de fichiers. L’acceptation métier et les décisions de crise nécessitent néanmoins une participation humaine.
Chez Atelier Rivage, chaque défaut reçoit un responsable et une date de correction, puis fait l’objet d’une nouvelle validation. La continuité d’activité progresse lorsque les écarts sont effectivement corrigés et retestés, pas lorsqu’ils sont simplement consignés dans un rapport.
Comment savoir rapidement si une sauvegarde est utilisable ?
Récupérez plusieurs éléments représentatifs dans un emplacement distinct, ouvrez-les et contrôlez leur contenu, leur date et leurs droits. Ce premier essai doit ensuite être complété par la remise en service d’une application pour vérifier ses dépendances et ses fonctions essentielles.
Un statut de sauvegarde réussi suffit-il à garantir la restauration ?
Non. Il indique que le traitement a satisfait les contrôles prévus par l’outil, mais ne démontre pas que toutes les données nécessaires sont couvertes ni que le service redémarrera. Une récupération effective et une validation métier restent nécessaires.
Peut-on tester sans arrêter les systèmes de production ?
Oui, en utilisant un environnement isolé avec des ressources adaptées. Il faut empêcher les envois de messages, les paiements, les synchronisations et les autres interactions susceptibles d’affecter les systèmes réels. Les différences avec l’environnement de secours prévu doivent être documentées.
À quelle fréquence faut-il renouveler les essais ?
La fréquence dépend des risques, des obligations et des changements techniques. Les services essentiels demandent des contrôles plus rapprochés. Un nouvel exercice est particulièrement utile après une migration, une modification importante des accès, un échec ou une correction majeure.
Les applications SaaS doivent-elles aussi être testées ?
Oui. Les fonctions de corbeille, d’historique et d’export varient selon les contrats. Il faut vérifier les éléments récupérables, les délais, les autorisations et la possibilité de réimporter les données avec leurs pièces jointes, relations et configurations nécessaires.